场景实拍
这是那个场景本身
1193 万高斯点重建出来的实景 —— 不是建模渲染,是从真实空间扫描下来的。 下面这张是在桌面壳里浏览时的画面。
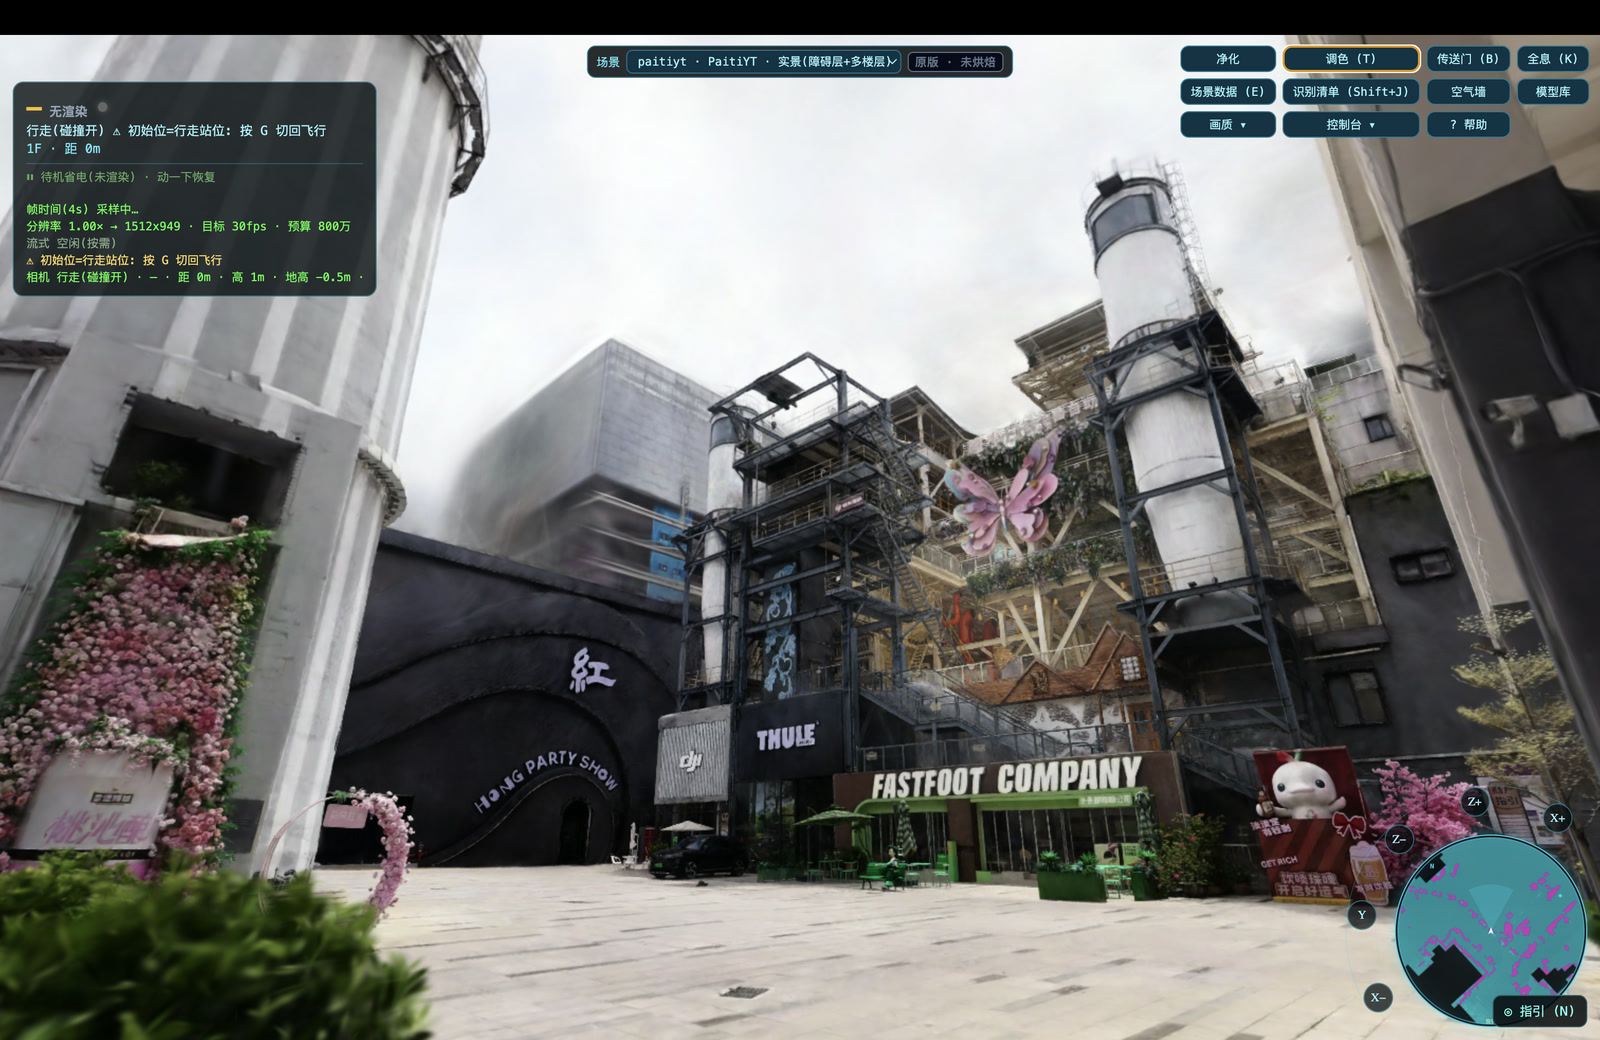
创意园大场景 · 1193 万高斯点 / 78 个流式分块
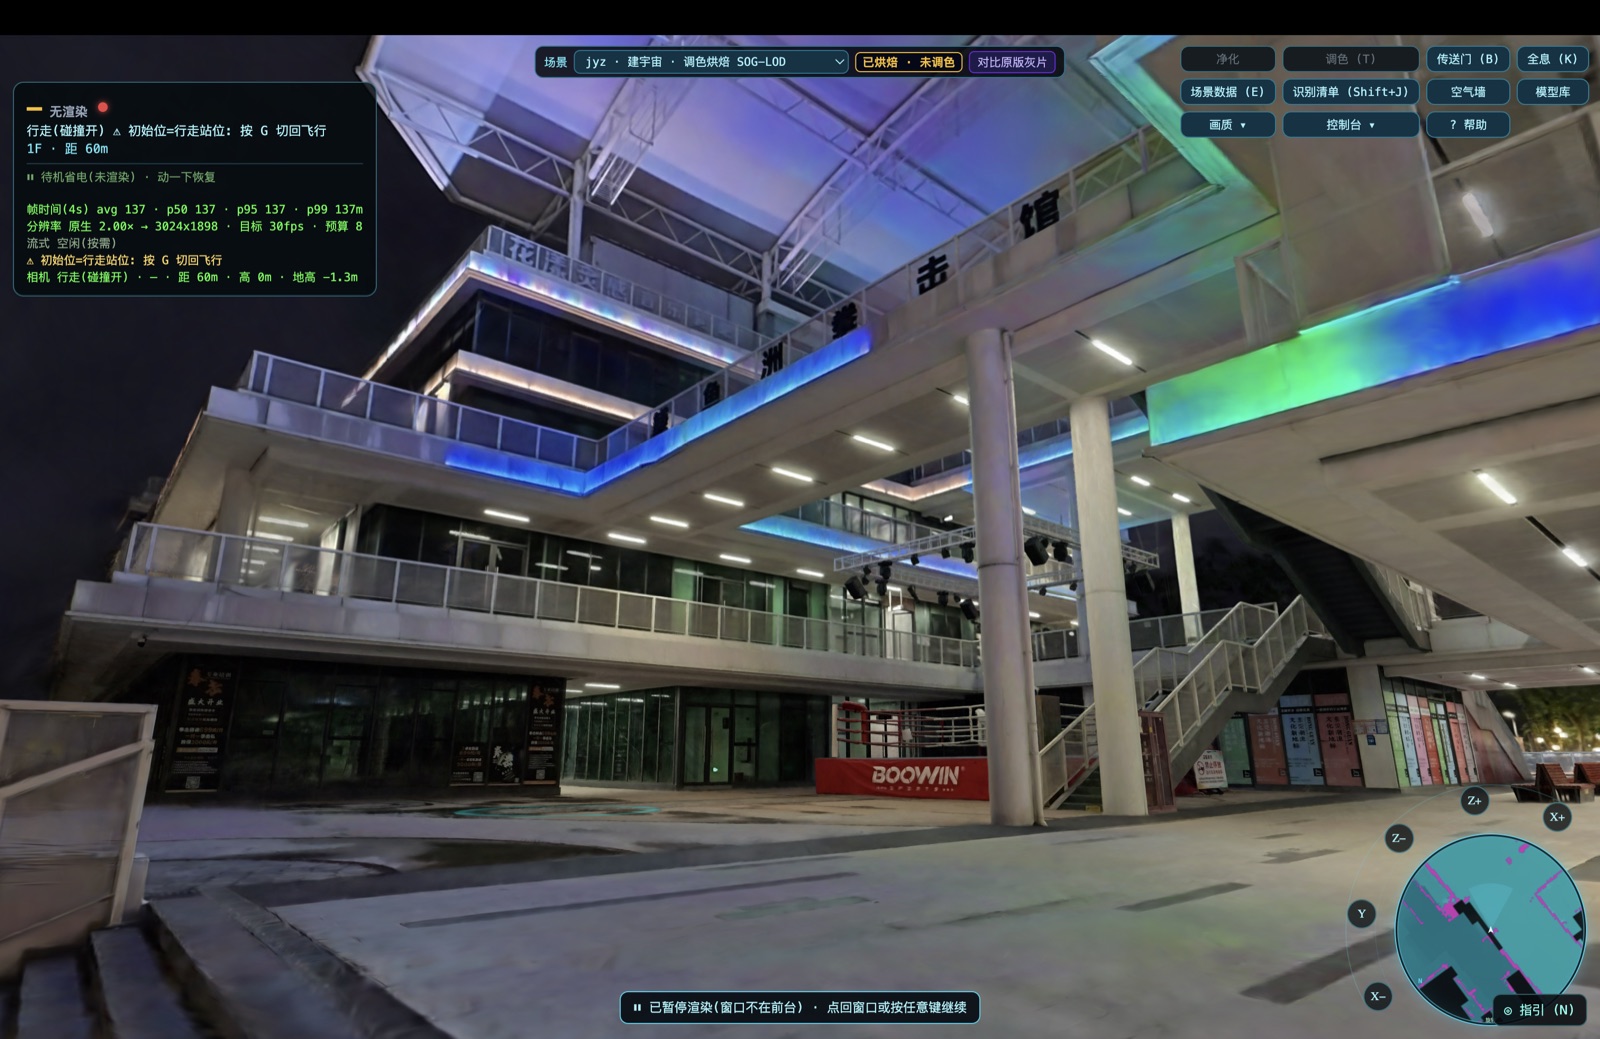
沉浸计划 · 另一处大场景(同一套管线,换场景即用)
渲染性能
这是自研的 WebGPU 流式渲染管线:八叉树分块按需加载,把千万级高斯点做到 浏览器里可实时浏览。下面是我们实测的性能数据与场景实拍。
场景实拍
1193 万高斯点重建出来的实景 —— 不是建模渲染,是从真实空间扫描下来的。 下面这张是在桌面壳里浏览时的画面。
实测数据
3DGS 帧率必须带四个数才有可比性:机型 / 分辨率 / 每帧渲染点数 / 场景总点数。 下面是同一台机器上的受控对照。
| 项目 | 值 |
|---|---|
| 场景规模 | 11,933,631 高斯点 · 78 个流式分块 · 167 MB(单层 LOD) |
| 测试环境 | Apple M1 Pro(10 核 CPU / 16 核 GPU)· Chrome · WebGPU · 视口 1400×900 |
| 每帧渲染点数 | 约 12M(像素比 1.0 时) |
| 分辨率自适应 关 | 39.9 fps · 帧时间 avg 25.0 ms · p95 31.4 ms |
| 分辨率自适应 开 | 60.0 fps · avg 16.7 ms · p95 17.9 ms · p99 19.2 ms(像素比 1.00 → 0.34) |
| 尖峰抑制 | 定位「拉块并发 128 → 解码风暴 → 单帧 483 ms」→ 降到 8,尖峰 3 次 → 0 次,max ≤ 75 ms |
| 一键烘焙 | PLY/SPZ → 流式 SOG-LOD,全量约 20.5 分钟 |
技术
模型烘焙成八叉树分块(每块 WebP 压缩的属性平面),相机移动时按需拉取。 1193 万点因此能压到 167MB 并渐进呈现。
显式创建 WebGPU 设备(引擎默认会自动回退 WebGL2)。WebGPU 在千万点量级才有明显收益, 低点数时差别很小 —— 所以我们保留 WebGL2 回退。
按时间戳窗口统计而不是按帧数窗口 —— 低帧率下按帧数统计会跨越几十秒、给出失真数字。
帧时间超标时降渲染分辨率,有余量再升回来。改 maxPixelRatio 后必须调用
syncCanvasSize() 才立即生效 —— 这个坑只有真跑过才知道。